チャットボットのナレッジベース:AIエージェントがサポートコンテンツをどのように活用するか
チャットボットのナレッジベースは、AIエージェントが質問に答えるために利用する情報源です。網羅性はコンテンツの問題であり、検索可能性は構造的な問題です。これら2つの問題をどのように解決できるでしょうか?
要するに、チャットボットのナレッジベースとは、AIエージェントが質問に答えることができる情報源の集合体を指します。具体的には、ヘルプセンターの記事、製品ドキュメント、ポリシーページ、社内Wiki、構造化データ(注文記録など)、あるいはその他の有用な情報などが含まれます。
したがって、チャットボットの知識ベースは、さまざまな契約に従う図書館のようなものです。各記事は独立しており、各ポリシーには独自の条件があり、ロボットがアクセスできる企業情報はすべて、正しいか無関係かのどちらかです。これは設計目標であり、自動的に保証されるものではありません。
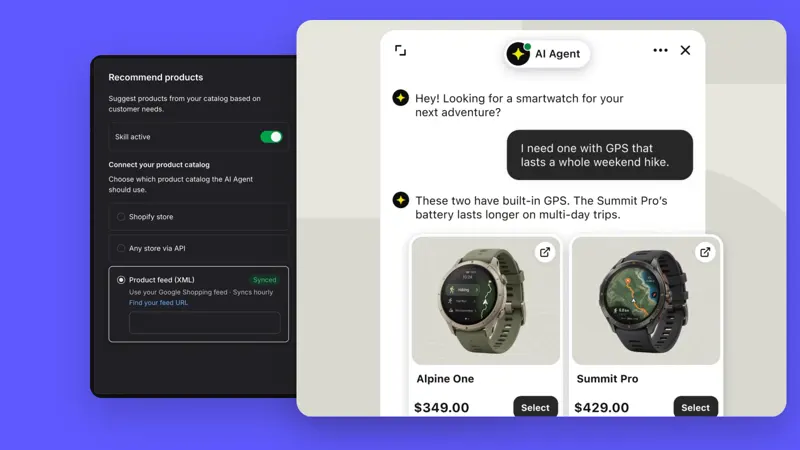
AIエージェントは、マッチングではなく意味に基づいて動作し、知識ベースチャットボットはスクリプトではなくライブラリから質問に答えるため、1つの記事で11通りの異なる方法で提示された質問に対応でき、誰もスクリプトを作成しないような多数の顧客からの問い合わせを網羅できます。
知識ベースに基づいて構築された、設計の不十分なチャットボットは自信満々に聞こえるかもしれないが、実際には欠陥があり、顧客の不満は、誰かがその回答に基づいて行動を起こした後に初めて明らかになる。
新しく採用したカスタマーサービス担当者に、ナレッジベースのみを使用して直近の実際の質問3件に回答してもらい、見つからない単語は保存してください。回答の正確性に影響を与える条項の追加を優先し、その後、異なる市場向けに同義語、タイトル、例外事項をまとめてください。